Decision Tree C4.5: Contoh Perhitungan Gain Ratio
Diterbitkan 24 September 2026
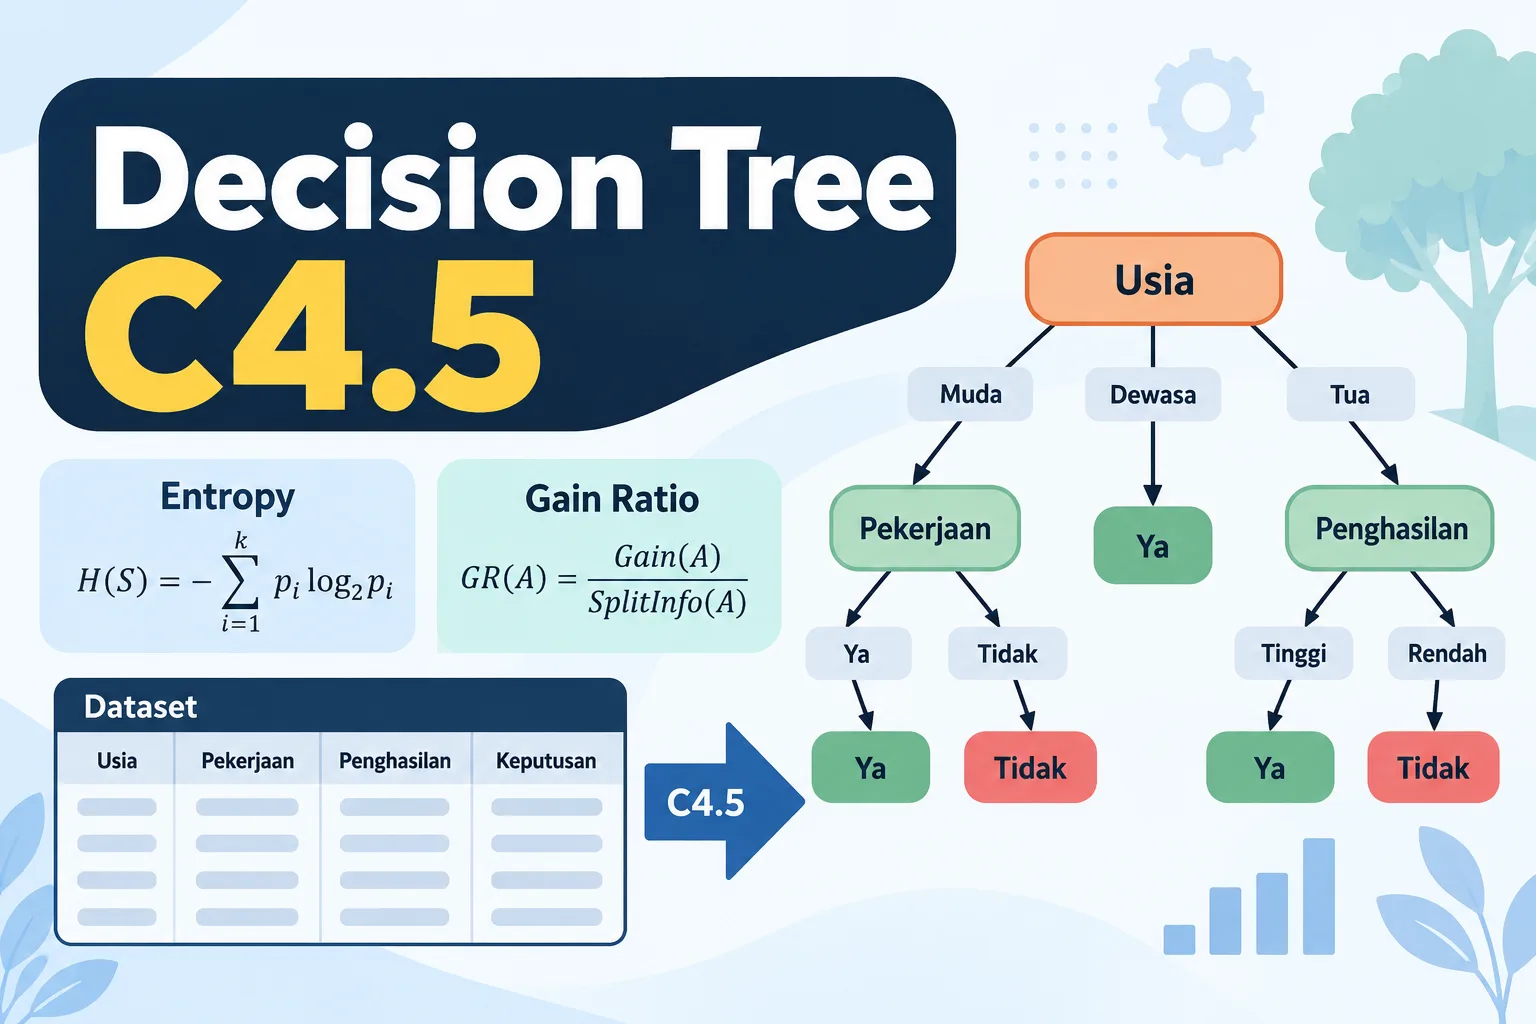
Decision Tree C4.5 adalah algoritma klasifikasi berbasis pohon keputusan yang mengembangkan konsep ID3. Pada setiap node, C4.5 menggunakan Gain Ratio untuk membantu memilih atribut pemisah.
Tutorial ini menggunakan contoh klasifikasi kelayakan kredit dengan atribut Penghasilan, Pekerjaan, Jaminan, dan Riwayat. Perhitungan dilakukan dari entropy, information gain, split information, gain ratio, pemilihan node, pembentukan pohon keputusan, hingga klasifikasi data baru.
Untuk mempelajari metode klasifikasi terkait, lihat juga algoritma ID3, Rough Set, dan metode Bayes.
Daftar Isi
- Pengertian Decision Tree C4.5
- Rumus C4.5
- #01 Data Latih
- #02 Menghitung Entropy Total
- #03 Menghitung Gain Ratio Setiap Atribut
- #04 Menentukan Root Node
- #05 Menghitung Cabang Jaminan = Tidak
- #06 Menghitung Cabang Penghasilan = Tinggi
- #07 Pohon Keputusan Akhir
- #08 Klasifikasi Data Uji
- Kelebihan dan Kekurangan
- Ringkasan
- FAQ C4.5
- Referensi
- Source Code C4.5
Pengertian Decision Tree C4.5
C4.5 adalah algoritma klasifikasi berbasis decision tree. Algoritma ini memilih atribut pemisah menggunakan Gain Ratio, yaitu Information Gain yang disesuaikan dengan Split Information.
Secara umum:
Data Latih
↓
Hitung Entropy
↓
Hitung Information Gain
↓
Hitung Split Information
↓
Hitung Gain Ratio
↓
Pilih atribut terbaik
↓
Bentuk cabang
↓
Ulangi sampai menjadi leaf
C4.5 berhubungan erat dengan ID3. Pada artikel ini seluruh atribut dibuat kategorikal agar perhitungan manual mudah diikuti.
Rumus C4.5
Entropy
Information Gain
Split Information
Gain Ratio
Atribut dengan Gain Ratio terbaik dipilih sebagai node pada contoh ini.
#01 Data Latih
Contoh menggunakan 12 data latih dengan target Kelayakan.
| No | Penghasilan | Pekerjaan | Jaminan | Riwayat | Kelayakan |
|---|---|---|---|---|---|
| 1 | Rendah | Kontrak | Tidak | Buruk | Tidak Layak |
| 2 | Rendah | Usaha | Tidak | Baik | Tidak Layak |
| 3 | Sedang | Kontrak | Ada | Baik | Layak |
| 4 | Sedang | Tetap | Ada | Baik | Layak |
| 5 | Tinggi | Tetap | Ada | Baik | Layak |
| 6 | Tinggi | Usaha | Ada | Baik | Layak |
| 7 | Sedang | Usaha | Tidak | Buruk | Tidak Layak |
| 8 | Tinggi | Kontrak | Tidak | Baik | Layak |
| 9 | Rendah | Tetap | Ada | Baik | Layak |
| 10 | Sedang | Kontrak | Tidak | Baik | Tidak Layak |
| 11 | Tinggi | Tetap | Tidak | Buruk | Tidak Layak |
| 12 | Rendah | Usaha | Ada | Baik | Layak |
Jumlah kelas:
Layak       = 7
Tidak Layak = 5
Total       = 12
#02 Menghitung Entropy Total
Proporsi kelas:
Maka:
#03 Menghitung Gain Ratio Setiap Atribut
Sebelum melihat tabel ringkasan, berikut contoh lengkap atribut Jaminan.
Perhitungan Atribut Jaminan pada Root
| Nilai | Jumlah | Layak | Tidak Layak | Entropy |
|---|---|---|---|---|
| Tidak | 6 | 1 | 5 | 0.6500 |
| Ada | 6 | 6 | 0 | -0.0000 |
Entropy setelah split:
Information Gain:
Split Information:
Gain Ratio:
Perbandingan seluruh atribut:
| Atribut | Entropy Setelah Split | Gain | Split Info | Gain Ratio |
|---|---|---|---|---|
| Penghasilan | 0.9371 | 0.0428 | 1.5850 | 0.0270 |
| Pekerjaan | 0.9371 | 0.0428 | 1.5850 | 0.0270 |
| Jaminan | 0.3250 | 0.6549 | 1.0000 | 0.6549 |
| Riwayat | 0.5732 | 0.4067 | 0.8113 | 0.5013 |
Nilai Gain Ratio terbesar adalah Jaminan = 0.6549.
#04 Menentukan Root Node
Berdasarkan hasil di atas:
Jaminan
├── Ada
└── Tidak
Cabang Jaminan = Ada terdiri dari 6 data dan semuanya berkelas Layak, sehingga langsung menjadi leaf.
Cabang Jaminan = Tidak terdiri dari 6 data dengan:
Layak       = 1
Tidak Layak = 5
Karena kelasnya masih bercampur, cabang ini harus dihitung kembali.
Pohon sementara:
Jaminan
├── Ada   → Layak
└── Tidak → dihitung lagi
#05 Menghitung Cabang Jaminan = Tidak
Entropy cabang:
Atribut yang tersisa:
Penghasilan
Pekerjaan
Riwayat
Perhitungan Atribut Penghasilan pada Jaminan = Tidak
| Nilai | Jumlah | Layak | Tidak Layak | Entropy |
|---|---|---|---|---|
| Rendah | 2 | 0 | 2 | -0.0000 |
| Sedang | 2 | 0 | 2 | -0.0000 |
| Tinggi | 2 | 1 | 1 | 1.0000 |
Gain Ratio Penghasilan:
Perhitungan Atribut Pekerjaan pada Jaminan = Tidak
| Nilai | Jumlah | Layak | Tidak Layak | Entropy |
|---|---|---|---|---|
| Kontrak | 3 | 1 | 2 | 0.9183 |
| Usaha | 2 | 0 | 2 | -0.0000 |
| Tetap | 1 | 0 | 1 | -0.0000 |
Gain Ratio Pekerjaan:
Perhitungan Atribut Riwayat pada Jaminan = Tidak
| Nilai | Jumlah | Layak | Tidak Layak | Entropy |
|---|---|---|---|---|
| Buruk | 3 | 0 | 3 | -0.0000 |
| Baik | 3 | 1 | 2 | 0.9183 |
Gain Ratio Riwayat:
Perbandingan:
| Atribut | Entropy Setelah Split | Gain | Split Info | Gain Ratio |
|---|---|---|---|---|
| Penghasilan | 0.3333 | 0.3167 | 1.5850 | 0.1998 |
| Pekerjaan | 0.4591 | 0.1909 | 1.4591 | 0.1308 |
| Riwayat | 0.4591 | 0.1909 | 1.0000 | 0.1909 |
Gain Ratio terbesar pada cabang ini adalah Penghasilan = 0.1998.
Pohon sementara:
Jaminan
├── Ada → Layak
└── Tidak
    └── Penghasilan
        ├── Rendah → Tidak Layak
        ├── Sedang → Tidak Layak
        └── Tinggi → dihitung lagi
#06 Menghitung Cabang Penghasilan = Tinggi
Pada jalur:
Jaminan = Tidak
Penghasilan = Tinggi
terdapat 2 data:
Layak       = 1
Tidak Layak = 1
Entropy:
Atribut tersisa adalah Pekerjaan dan Riwayat.
Perhitungan Atribut Pekerjaan pada Penghasilan = Tinggi
| Nilai | Jumlah | Layak | Tidak Layak | Entropy |
|---|---|---|---|---|
| Kontrak | 1 | 1 | 0 | -0.0000 |
| Tetap | 1 | 0 | 1 | -0.0000 |
Gain Ratio:
Perhitungan Atribut Riwayat pada Penghasilan = Tinggi
| Nilai | Jumlah | Layak | Tidak Layak | Entropy |
|---|---|---|---|---|
| Baik | 1 | 1 | 0 | -0.0000 |
| Buruk | 1 | 0 | 1 | -0.0000 |
Gain Ratio:
Kedua atribut menghasilkan Gain Ratio yang sama, yaitu 1.0000. Pada implementasi sumber artikel, atribut diproses sesuai urutan atribut yang tersedia sehingga Pekerjaan dipilih lebih dahulu pada kondisi tie ini.
Cabang menjadi:
Pekerjaan
├── Kontrak → Layak
└── Tetap   → Tidak Layak
Dengan nama heading yang diberi konteks seperti di atas, heading “Perhitungan Atribut Pekerjaan” tidak lagi muncul secara identik lebih dari sekali.
#07 Pohon Keputusan Akhir
Pohon keputusan yang terbentuk:
Jaminan
├── Ada
│   └── Layak
│
└── Tidak
    └── Penghasilan
        ├── Rendah
        │   └── Tidak Layak
        ├── Sedang
        │   └── Tidak Layak
        └── Tinggi
            └── Pekerjaan
                ├── Kontrak
                │   └── Layak
                └── Tetap
                    └── Tidak Layak
Setiap jalur dari root ke leaf dapat dibaca sebagai rule IF-THEN.
Contoh:
IF Jaminan = Ada
THEN Kelayakan = Layak
dan:
IF Jaminan = Tidak
AND Penghasilan = Tinggi
AND Pekerjaan = Kontrak
THEN Kelayakan = Layak
#08 Klasifikasi Data Uji
Data uji:
| Atribut | Nilai |
|---|---|
| Penghasilan | Tinggi |
| Pekerjaan | Kontrak |
| Jaminan | Tidak |
| Riwayat | Baik |
Penelusuran pohon:
Jaminan = Tidak
↓
Penghasilan = Tinggi
↓
Pekerjaan = Kontrak
↓
Layak
Hasil klasifikasi:
Kelebihan dan Kekurangan
Kelebihan
- Menghasilkan pohon keputusan yang mudah dibaca.
- Menggunakan Gain Ratio untuk pemilihan atribut.
- Dapat diterjemahkan menjadi rule IF-THEN.
- C4.5 mendukung atribut kontinu melalui proses penentuan threshold.
Kekurangan
- Pohon dapat menjadi kompleks ketika atribut dan data bertambah banyak.
- Hasil dipengaruhi data latih.
- Perhitungan manual menjadi panjang jika banyak atribut dan cabang.
- Implementasi perlu menangani kondisi tie dan data yang tidak muncul pada data latih secara konsisten.
Sebagai perbandingan algoritma pohon keputusan yang lebih dasar, lihat ID3. Untuk metode klasifikasi berbasis aturan/data lain, Anda dapat mempelajari Rough Set dan Bayes.
Ringkasan
Entropy total:
0.9799
Gain Ratio root terbesar:
Jaminan = 0.6549
Pada cabang:
Jaminan = Tidak
atribut berikutnya adalah:
Penghasilan
Pada cabang:
Jaminan = Tidak
Penghasilan = Tinggi
Pekerjaan dan Riwayat sama-sama memiliki Gain Ratio 1.0000. Implementasi contoh memilih Pekerjaan berdasarkan urutan atribut.
Pohon akhir menghasilkan klasifikasi data uji:
Layak
FAQ C4.5
Apa perbedaan ID3 dan C4.5?
Pada sumber artikel ini, ID3 dijelaskan menggunakan Information Gain, sedangkan C4.5 menggunakan Gain Ratio dalam pemilihan atribut.
Apa fungsi entropy?
Entropy mengukur tingkat ketidakmurnian kelas pada sekumpulan data.
Apa fungsi Information Gain?
Information Gain mengukur pengurangan entropy setelah data dibagi berdasarkan atribut.
Mengapa menggunakan Split Information?
Split Information digunakan sebagai penyebut pada Gain Ratio untuk menyesuaikan nilai Information Gain.
Apa yang dipilih sebagai root pada contoh?
Atribut Jaminan karena memiliki Gain Ratio terbesar pada dataset contoh.
Mengapa heading Pekerjaan sekarang berbeda?
Karena atribut Pekerjaan dihitung pada lebih dari satu node. Heading diberi konteks cabang agar tidak identik dan daftar isi tidak membingungkan.
Apakah C4.5 dapat menggunakan data numerik?
Ya. C4.5 dapat menangani atribut kontinu dengan menentukan titik pemisah atau threshold. Contoh artikel ini menggunakan data kategorikal agar perhitungan manual lebih mudah.
Referensi
- Quinlan, J. R. (1993). C4.5: Programs for Machine Learning. Morgan Kaufmann.
- Han, J., Kamber, M., & Pei, J. (2012). Data Mining: Concepts and Techniques, 3rd Edition. Morgan Kaufmann.
Source Code C4.5
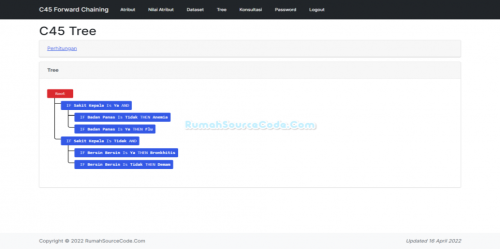
Berikut source code yang menggunakan algoritma Decision Tree C4.5 pada RumahSourceCode.


Ada yang Ditanyakan?
Jika masih ada kesulitan atau kekeliruan tentang metode di atas, silakan hubungi kami melalui halaman Kontak.
Perhitungan Excel tersedia melalui halaman Download, sedangkan aplikasi terkait dapat dilihat pada halaman Daftar Source Code.
Donasi digunakan untuk biaya server dan mendukung pembuatan tutorial metode atau algoritma lainnya.




Komentar
Tulis Komentar