FP-Growth: Contoh Perhitungan FP-Tree dan Association Rule
Diterbitkan 25 September 2026
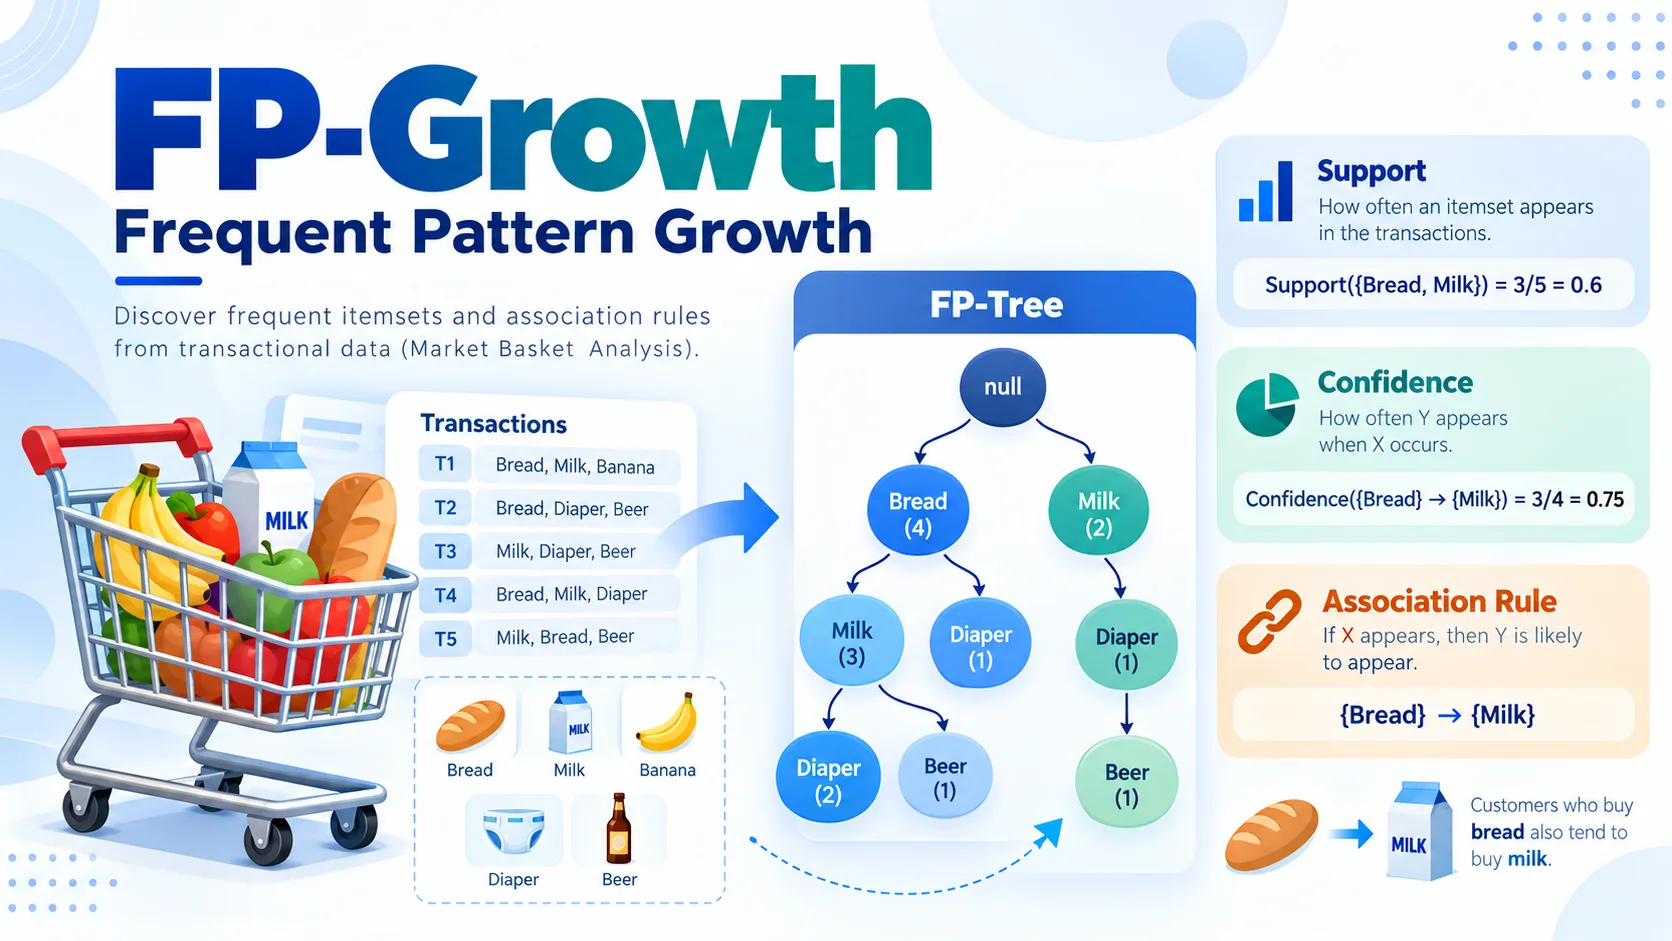
FP-Growth (Frequent Pattern Growth) adalah algoritma data mining untuk menemukan frequent itemset tanpa membentuk kandidat itemset berulang seperti pada Apriori. FP-Growth memampatkan transaksi ke dalam struktur FP-Tree, kemudian menambang pola melalui conditional pattern base dan conditional FP-Tree.
Tutorial ini menggunakan contoh market basket analysis minimarket dengan 5 transaksi. Perhitungan dilakukan mulai dari support count, minimum support, F-List, pengurutan transaksi, pembentukan FP-Tree, conditional pattern base, frequent itemset, sampai association rule menggunakan confidence dan lift.
Untuk membandingkan pendekatan association rule, lihat juga algoritma Apriori dan Fuzzy C-Covering.
Daftar Isi
- Pengertian FP-Growth
- Perbedaan FP-Growth dan Apriori
- Istilah Penting
- Rumus FP-Growth
- #01 Menentukan Data Transaksi
- #02 Menentukan Minimum Support
- #03 Menghitung Frekuensi Setiap Item
- #04 Membentuk F-List
- #05 Mengurutkan Item pada Transaksi
- #06 Membentuk FP-Tree
- #07 Membentuk Conditional Pattern Base
- #08 Membentuk Conditional FP-Tree
- #09 Menentukan Frequent Itemset
- #10 Membentuk Association Rule
- Cara Membaca Lift
- Kelebihan dan Kekurangan
- Ringkasan
- FAQ FP-Growth
- Referensi
- Source Code FP-Growth
Pengertian FP-Growth
FP-Growth adalah singkatan dari Frequent Pattern Growth. Algoritma ini mencari pola item yang sering muncul bersama dengan memanfaatkan struktur pohon bernama Frequent Pattern Tree (FP-Tree).
Ide utamanya:
Data Transaksi
↓
Hitung Frekuensi Item
↓
Buang Item Tidak Frequent
↓
Bentuk F-List
↓
Urutkan Item Setiap Transaksi
↓
Bangun FP-Tree
↓
Conditional Pattern Base
↓
Conditional FP-Tree
↓
Frequent Itemset
↓
Association Rule
FP-Growth tidak perlu membangkitkan kandidat C1, C2, C3, dan seterusnya secara eksplisit seperti Apriori.
Perbedaan FP-Growth dan Apriori
| Aspek | FP-Growth | Apriori |
|---|---|---|
| Struktur utama | FP-Tree | Kandidat itemset |
| Candidate generation | Tidak eksplisit | Ya |
| Pemindaian database | Relatif sedikit | Berulang |
| Data padat | Umumnya lebih efisien | Kandidat dapat sangat banyak |
| Interpretasi manual | Lebih kompleks | Lebih sederhana |
| Hasil | Frequent itemset | Frequent itemset |
Jika ingin memahami pola kandidat secara bertahap, Apriori lebih mudah dipelajari terlebih dahulu. Jika jumlah transaksi besar dan banyak item saling berulang, FP-Growth dapat mengurangi kebutuhan candidate generation.
Istilah Penting
Pengertian Support Count
Support count adalah jumlah transaksi yang mengandung sebuah item atau itemset.
Contoh:
Roti muncul pada 4 transaksi
maka:
Minimum Support
Minimum support menentukan batas itemset yang dianggap frequent.
Jika:
Minimum Support = 60%
Jumlah transaksi = 5
maka minimum support count:
Itemset harus muncul minimal 3 transaksi.
F-List
F-List adalah daftar item frequent yang diurutkan berdasarkan support count dari terbesar ke terkecil.
FP-Tree
FP-Tree adalah struktur pohon yang menyimpan transaksi yang sudah diurutkan berdasarkan F-List.
Prefix transaksi yang sama akan berbagi node sehingga data menjadi lebih ringkas.
Conditional Pattern Base
Conditional pattern base adalah kumpulan prefix path menuju suatu item target.
Conditional FP-Tree
Conditional FP-Tree adalah FP-Tree lokal yang dibentuk dari conditional pattern base setelah item yang tidak memenuhi minimum support dihapus.
Rumus FP-Growth
Rumus Support Count
Keterangan:
- \(SC(X)\) = support count itemset \(X\),
- \(T_i\) = transaksi ke-\(i\).
Support
Jika dinyatakan persen:
Confidence
Untuk rule:
confidence:
Lift
Interpretasi:
- \(Lift>1\): hubungan positif,
- \(Lift=1\): cenderung independen,
- \(Lift<1\): hubungan negatif.
#01 Menentukan Data Transaksi
Digunakan 5 transaksi:
| Transaksi | Item |
|---|---|
| T1 | Roti, Susu |
| T2 | Roti, Popok, Kopi, Telur |
| T3 | Susu, Popok, Kopi, Cola |
| T4 | Roti, Susu, Popok, Kopi |
| T5 | Roti, Susu, Popok, Cola |
Jumlah transaksi:
#02 Menentukan Minimum Support
Parameter:
Minimum Support = 60%
Minimum Confidence = 70%
Minimum support count:
Jadi:
Setiap item atau itemset harus muncul minimal 3 kali agar dianggap frequent.
#03 Menghitung Frekuensi Setiap Item
Hitung jumlah transaksi yang mengandung masing-masing item.
Contoh Roti
Roti terdapat pada:
T1
T2
T4
T5
Maka:
Support:
Contoh Kopi
Kopi terdapat pada:
T2
T3
T4
Maka:
Support:
Hasil seluruh item:
| Item | Support Count | Support | Status |
|---|---|---|---|
| Roti | 4 | 80% | Frequent |
| Susu | 4 | 80% | Frequent |
| Popok | 4 | 80% | Frequent |
| Kopi | 3 | 60% | Frequent |
| Cola | 2 | 40% | Tidak |
| Telur | 1 | 20% | Tidak |
Karena minimum support count adalah 3, Cola dan Telur dikeluarkan dari proses FP-Tree.
#04 Membentuk F-List
Item frequent:
Roti = 4
Susu = 4
Popok = 4
Kopi = 3
Karena Roti, Susu, dan Popok memiliki support count sama, digunakan urutan tetap agar proses manual konsisten:
Roti
Susu
Popok
Kopi
F-List:
| Urutan | Item | Support Count |
|---|---|---|
| 1 | Roti | 4 |
| 2 | Susu | 4 |
| 3 | Popok | 4 |
| 4 | Kopi | 3 |
Jika support count sama, aturan tie-breaking harus dibuat konsisten. Urutan tie tidak mengubah nilai support itemset, tetapi dapat mengubah bentuk visual FP-Tree.
#05 Mengurutkan Item pada Transaksi
Cola dan Telur dihapus karena tidak frequent.
Kemudian item setiap transaksi diurutkan mengikuti F-List.
| Transaksi | Setelah Filtering dan Sorting |
|---|---|
| T1 | Roti → Susu |
| T2 | Roti → Popok → Kopi |
| T3 | Susu → Popok → Kopi |
| T4 | Roti → Susu → Popok → Kopi |
| T5 | Roti → Susu → Popok |
Contoh T2
Transaksi asli:
Roti, Popok, Kopi, Telur
Telur tidak frequent, sehingga:
Roti, Popok, Kopi
Contoh T3
Transaksi asli:
Susu, Popok, Kopi, Cola
Cola dibuang:
Susu, Popok, Kopi
#06 Membentuk FP-Tree
Gunakan root:
NULL
Memasukkan T1
NULL
└── Roti:1
    └── Susu:1
Memasukkan T2
T2:
Roti → Popok → Kopi
Node Roti sudah ada, count naik:
NULL
└── Roti:2
    ├── Susu:1
    └── Popok:1
        └── Kopi:1
Memasukkan T3
Susu → Popok → Kopi
Karena prefix dimulai Susu, dibuat cabang baru:
NULL
├── Roti:2
│   ├── Susu:1
│   └── Popok:1
│       └── Kopi:1
└── Susu:1
    └── Popok:1
        └── Kopi:1
Memasukkan T4
Roti → Susu → Popok → Kopi
Setelah count diperbarui:
NULL
├── Roti:3
│   ├── Susu:2
│   │   └── Popok:1
│   │       └── Kopi:1
│   └── Popok:1
│       └── Kopi:1
└── Susu:1
    └── Popok:1
        └── Kopi:1
Memasukkan T5
Roti → Susu → Popok
FP-Tree akhir:
NULL
├── Roti:4
│   ├── Susu:3
│   │   └── Popok:2
│   │       └── Kopi:1
│   └── Popok:1
│       └── Kopi:1
└── Susu:1
    └── Popok:1
        └── Kopi:1
Count node menunjukkan berapa transaksi melewati prefix tersebut.
#07 Membentuk Conditional Pattern Base
Mining dilakukan dari item dengan support terendah pada F-List.
Urutan:
Kopi
Popok
Susu
Roti
Conditional Pattern Base untuk Kopi
Kopi terdapat pada tiga path:
Roti → Popok → Kopi : 1
Roti → Susu → Popok → Kopi : 1
Susu → Popok → Kopi : 1
Prefix sebelum Kopi:
| Prefix Path | Count |
|---|---|
| Roti, Popok | 1 |
| Roti, Susu, Popok | 1 |
| Susu, Popok | 1 |
Hitung frekuensi conditional:
Roti  = 2
Susu  = 2
Popok = 3
Minimum support count:
3
Maka hanya:
Popok
yang bertahan.
Hasil frequent pattern:
dengan:
#08 Membentuk Conditional FP-Tree
Conditional FP-Tree untuk Kopi
Dari conditional frequency:
Roti  = 2
Susu  = 2
Popok = 3
setelah pruning:
Popok = 3
Conditional FP-Tree:
NULL
└── Popok:3
Frequent itemset:
Conditional FP-Tree untuk Popok
Prefix path menuju Popok:
Roti : 1
Roti → Susu : 2
Susu : 1
Conditional frequency:
Roti = 3
Susu = 3
Keduanya memenuhi minimum support count 3.
Maka diperoleh:
dan:
Kombinasi tiga item:
hanya muncul pada 2 transaksi sehingga tidak frequent.
Conditional FP-Tree untuk Susu
Prefix menuju Susu dari jalur dengan Roti:
Roti : 3
Maka:
#09 Menentukan Frequent Itemset
Frequent 1-itemset:
| Itemset | Support Count | Support |
|---|---|---|
| {Roti} | 4 | 80% |
| {Susu} | 4 | 80% |
| {Popok} | 4 | 80% |
| {Kopi} | 3 | 60% |
Frequent 2-itemset:
| Itemset | Support Count | Support |
|---|---|---|
| {Roti, Susu} | 3 | 60% |
| {Roti, Popok} | 3 | 60% |
| {Susu, Popok} | 3 | 60% |
| {Popok, Kopi} | 3 | 60% |
Tidak ada frequent 3-itemset yang mencapai minimum support count 3.
#10 Membentuk Association Rule
Minimum confidence:
Contoh Rule Kopi → Popok
Support:
Support Kopi:
Confidence:
atau:
Lift:
Karena:
hubungannya positif.
Rule yang memenuhi minimum confidence:
| Rule | Support | Confidence | Lift |
|---|---|---|---|
| Kopi → Popok | 60% | 100% | 1.2500 |
| Popok → Kopi | 60% | 75% | 1.2500 |
| Roti → Susu | 60% | 75% | 0.9375 |
| Susu → Roti | 60% | 75% | 0.9375 |
| Roti → Popok | 60% | 75% | 0.9375 |
| Popok → Roti | 60% | 75% | 0.9375 |
| Susu → Popok | 60% | 75% | 0.9375 |
| Popok → Susu | 60% | 75% | 0.9375 |
Pada data contoh, rule dengan lift tertinggi adalah:
Kopi → Popok
Popok → Kopi
keduanya memiliki:
Cara Membaca Lift
Lift membantu membedakan rule yang hanya memiliki confidence tinggi karena consequent memang sering muncul.
Contoh:
Kopi → Popok
Confidence:
Support Popok:
Lift:
Artinya kemunculan Kopi meningkatkan kecenderungan Popok dibanding baseline Popok pada data contoh.
Sebaliknya:
Roti → Susu
memiliki confidence:
tetapi:
karena Susu sendiri sudah muncul pada 80% transaksi.
Untuk pendekatan association rule berbasis candidate generation, lihat Apriori. Untuk pendekatan fuzzy, lihat Fuzzy C-Covering.
Kelebihan dan Kekurangan
Kelebihan FP-Growth
- Tidak melakukan candidate generation berulang seperti Apriori.
- Database dapat dipadatkan ke dalam FP-Tree.
- Efektif ketika banyak transaksi berbagi prefix.
- Dapat menemukan frequent pattern secara rekursif.
- Cocok untuk market basket analysis.
Kekurangan FP-Growth
- FP-Tree lebih kompleks dijelaskan secara manual.
- Implementasi membutuhkan struktur tree dan header/link yang baik.
- FP-Tree dapat besar jika transaksi sangat beragam.
- Minimum support yang terlalu rendah dapat menghasilkan banyak pattern.
- Hasil association rule tetap perlu dievaluasi menggunakan confidence, lift, atau metrik lain.
Ringkasan
Parameter:
Jumlah transaksi = 5
Minimum Support = 60%
Minimum Support Count = 3
Minimum Confidence = 70%
F-List:
Roti:4
Susu:4
Popok:4
Kopi:3
Frequent 2-itemset:
{Roti,Susu}:3
{Roti,Popok}:3
{Susu,Popok}:3
{Popok,Kopi}:3
Rule terkuat berdasarkan lift:
Kopi → Popok
dengan:
Support = 60%
Confidence = 100%
Lift = 1.25
FP-Growth memperoleh pola tersebut melalui FP-Tree dan conditional pattern base tanpa harus membentuk kandidat itemset bertingkat seperti Apriori.
FAQ FP-Growth
Apa kepanjangan FP-Growth?
FP-Growth adalah Frequent Pattern Growth.
Apa fungsi FP-Growth?
Untuk mencari frequent itemset dari data transaksi dengan memanfaatkan FP-Tree.
Apa perbedaan FP-Growth dan Apriori?
Apriori membentuk kandidat itemset secara bertingkat, sedangkan FP-Growth menggunakan FP-Tree dan conditional pattern mining.
Apa itu FP-Tree?
FP-Tree adalah struktur pohon yang menyimpan transaksi frequent dalam bentuk prefix yang dapat dibagikan antartransaksi.
Apa itu F-List?
Daftar item frequent yang diurutkan berdasarkan support count.
Apa itu conditional pattern base?
Kumpulan prefix path yang mengarah ke item target.
Apa itu conditional FP-Tree?
FP-Tree lokal yang dibangun dari conditional pattern base setelah pruning.
Bagaimana menentukan minimum support count?
Kalikan minimum support dengan jumlah transaksi lalu gunakan batas count yang sesuai.
Pada contoh:
Apa itu confidence?
Confidence mengukur seberapa sering consequent muncul ketika antecedent muncul.
Apa itu lift?
Lift membandingkan confidence rule dengan frekuensi dasar consequent.
Apakah lift harus lebih dari 1?
Tidak harus untuk menghasilkan rule, tetapi lift lebih dari 1 menunjukkan hubungan positif.
Apakah FP-Growth termasuk classification?
Tidak. FP-Growth terutama digunakan untuk frequent pattern mining dan association rule.
Apakah FP-Growth dapat digunakan untuk data penjualan?
Ya. Market basket analysis merupakan salah satu penerapan paling umum.
Apakah FP-Growth membutuhkan data label?
Tidak. FP-Growth merupakan metode unsupervised frequent pattern mining dan tidak membutuhkan label kelas.
Referensi
- Han, J., Pei, J., & Yin, Y. (2000). Mining Frequent Patterns without Candidate Generation. Proceedings of ACM SIGMOD.
- Han, J., Kamber, M., & Pei, J. (2012). Data Mining: Concepts and Techniques. Third Edition. Morgan Kaufmann.
- Agrawal, R., & Srikant, R. (1994). Fast Algorithms for Mining Association Rules. Proceedings of VLDB.
Source Code FP-Growth
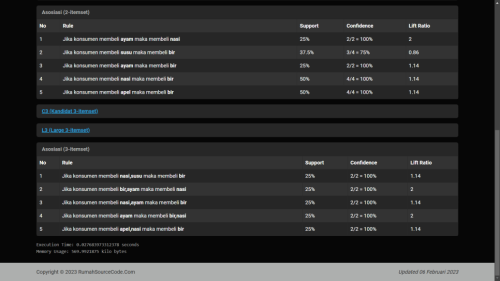
Berikut source code yang menggunakan algoritma FP-Growth pada RumahSourceCode.


Ada yang Ditanyakan?
Jika masih ada kesulitan atau kekeliruan tentang metode di atas, silakan hubungi kami melalui halaman Kontak.
Perhitungan Excel tersedia melalui halaman Download, sedangkan aplikasi terkait dapat dilihat pada halaman Daftar Source Code.
Donasi digunakan untuk biaya server dan mendukung pembuatan tutorial metode atau algoritma lainnya.




Komentar
Tulis Komentar