K-Means Clustering: Contoh Perhitungan Manual
Diterbitkan 24 September 2026
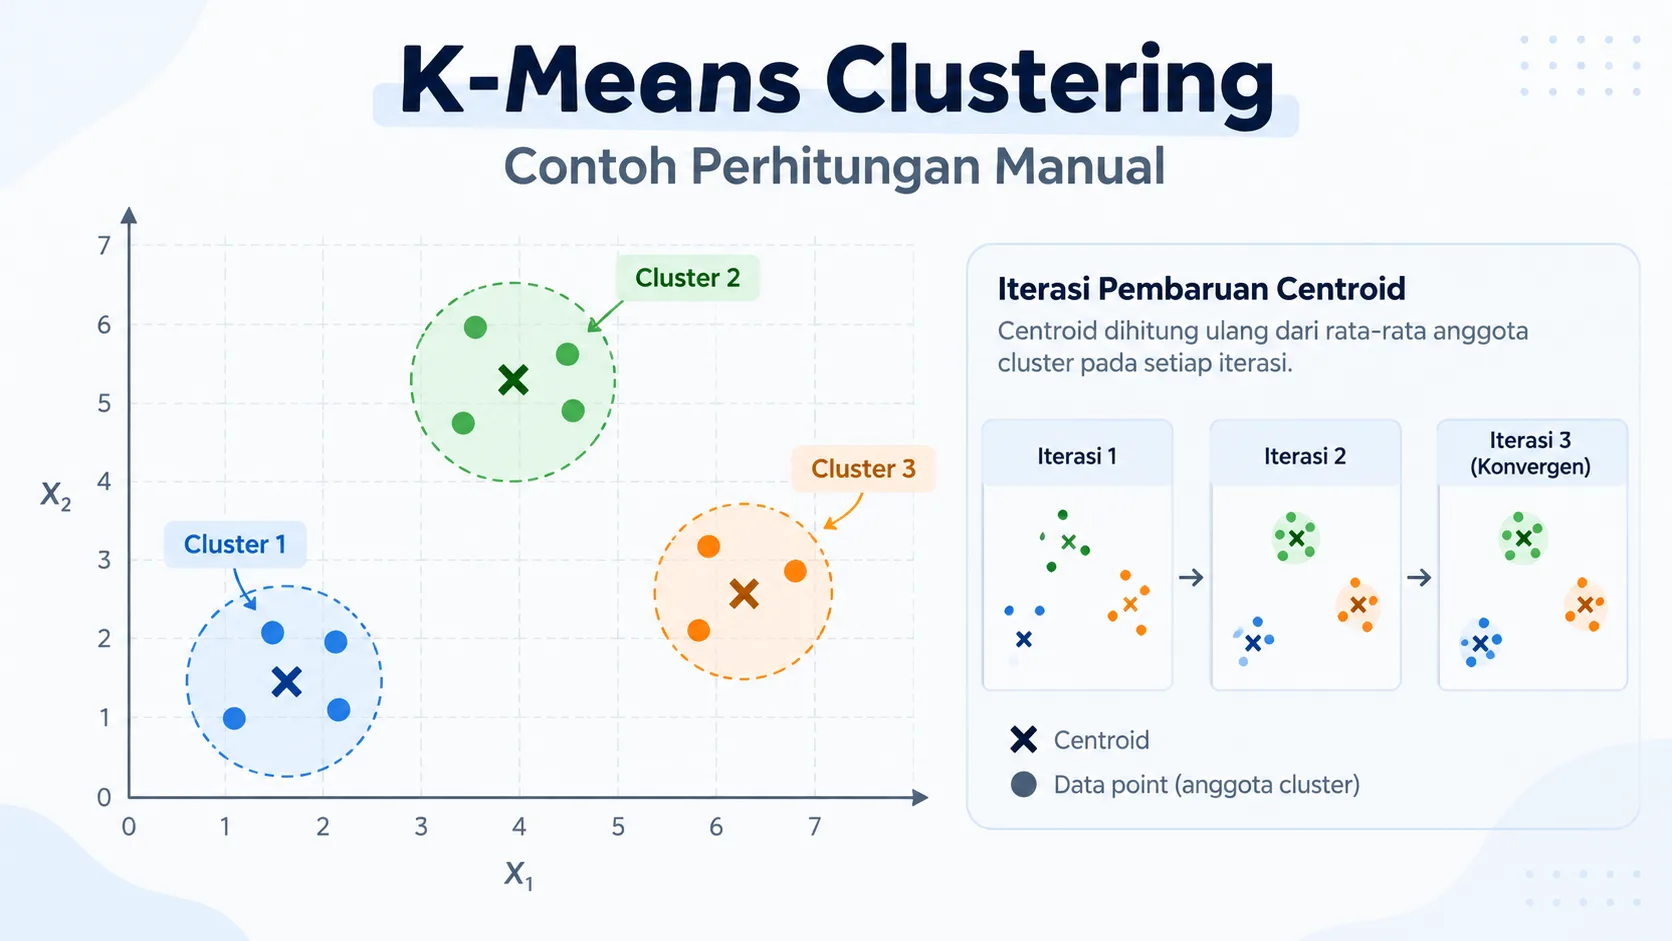
K-Means Clustering adalah algoritma unsupervised learning untuk mengelompokkan data berdasarkan kedekatan terhadap titik pusat cluster atau centroid. Tutorial ini menggunakan contoh segmentasi pelanggan berdasarkan atribut pendapatan dan pengeluaran.
Proses perhitungan dilakukan mulai dari menentukan jumlah cluster, memilih centroid awal, menghitung Euclidean Distance, menentukan anggota cluster, menghitung centroid baru, hingga iterasi berhenti ketika centroid sudah stabil.
Untuk membandingkan metode clustering lain, lihat juga K-Medoids, DBSCAN, dan Fuzzy C-Means.
Daftar Isi
- Pengertian K-Means Clustering
- Rumus Euclidean Distance
- Data Contoh
- #01 Menentukan Jumlah Cluster
- #02 Menentukan Centroid Awal
- #03 Iterasi K-Means
- #04 Hasil Akhir Cluster
- K-Means vs Metode Clustering Lain
- Ringkasan
- FAQ K-Means
- Referensi
- Source Code K-Means
Pengertian K-Means Clustering
K-Means membagi data ke dalam sejumlah cluster berdasarkan jarak ke centroid. Setiap data ditempatkan pada cluster dengan centroid terdekat, kemudian centroid dihitung ulang dari rata-rata seluruh anggota cluster.
Proses tersebut diulang sampai centroid tidak berubah secara berarti atau kondisi berhenti lain tercapai.
Rumus Euclidean Distance
Pada contoh ini jarak data terhadap centroid dihitung menggunakan Euclidean Distance:
Untuk dua atribut:
Data Contoh
Kasus menggunakan 10 pelanggan dengan dua atribut sederhana agar perhitungan manual mudah diikuti.
| Kode | Nama | Pendapatan | Pengeluaran |
|---|---|---|---|
| D1 | Pelanggan 1 | 2 | 3 |
| D2 | Pelanggan 2 | 3 | 4 |
| D3 | Pelanggan 3 | 2 | 5 |
| D4 | Pelanggan 4 | 5 | 6 |
| D5 | Pelanggan 5 | 6 | 7 |
| D6 | Pelanggan 6 | 6 | 5 |
| D7 | Pelanggan 7 | 8 | 3 |
| D8 | Pelanggan 8 | 9 | 2 |
| D9 | Pelanggan 9 | 8 | 4 |
| D10 | Pelanggan 10 | 9 | 5 |
#01 Menentukan Jumlah Cluster
Jumlah cluster ditentukan:
Artinya seluruh data dikelompokkan menjadi tiga cluster.
#02 Menentukan Centroid Awal
Centroid awal dipilih dari D1, D5, dan D8 agar contoh mudah direproduksi.
| Cluster | Sumber Data | Pendapatan | Pengeluaran |
|---|---|---|---|
| C1 | D1 | 2.0000 | 3.0000 |
| C2 | D5 | 6.0000 | 7.0000 |
| C3 | D8 | 9.0000 | 2.0000 |
#03 Iterasi K-Means
Pada setiap iterasi, jarak setiap data terhadap seluruh centroid dihitung. Data kemudian ditempatkan pada cluster yang mempunyai jarak paling kecil.
Iterasi 1
Centroid Sebelum Perhitungan Iterasi 1
| Cluster | Pendapatan | Pengeluaran |
|---|---|---|
| C1 | 2.0000 | 3.0000 |
| C2 | 6.0000 | 7.0000 |
| C3 | 9.0000 | 2.0000 |
Contoh Perhitungan Jarak Iterasi 1
Contoh jarak Pelanggan 2 (3, 4) terhadap centroid C1 (2.0000, 3.0000):
Jarak dan Cluster Iterasi 1
| Data | Jarak C1 | Jarak C2 | Jarak C3 | Cluster |
|---|---|---|---|---|
| D1 - Pelanggan 1 | 0.0000 | 5.6569 | 7.0711 | C1 |
| D2 - Pelanggan 2 | 1.4142 | 4.2426 | 6.3246 | C1 |
| D3 - Pelanggan 3 | 2.0000 | 4.4721 | 7.6158 | C1 |
| D4 - Pelanggan 4 | 4.2426 | 1.4142 | 5.6569 | C2 |
| D5 - Pelanggan 5 | 5.6569 | 0.0000 | 5.8310 | C2 |
| D6 - Pelanggan 6 | 4.4721 | 2.0000 | 4.2426 | C2 |
| D7 - Pelanggan 7 | 6.0000 | 4.4721 | 1.4142 | C3 |
| D8 - Pelanggan 8 | 7.0711 | 5.8310 | 0.0000 | C3 |
| D9 - Pelanggan 9 | 6.0828 | 3.6056 | 2.2361 | C3 |
| D10 - Pelanggan 10 | 7.2801 | 3.6056 | 3.0000 | C3 |
Centroid Baru Iterasi 1
| Cluster | Anggota | Centroid Pendapatan | Centroid Pengeluaran |
|---|---|---|---|
| C1 | D1, D2, D3 | 2.3333 | 4.0000 |
| C2 | D4, D5, D6 | 5.6667 | 6.0000 |
| C3 | D7, D8, D9, D10 | 8.5000 | 3.5000 |
Centroid masih berubah sehingga perhitungan dilanjutkan ke iterasi berikutnya.
Iterasi 2
Centroid Sebelum Perhitungan Iterasi 2
| Cluster | Pendapatan | Pengeluaran |
|---|---|---|
| C1 | 2.3333 | 4.0000 |
| C2 | 5.6667 | 6.0000 |
| C3 | 8.5000 | 3.5000 |
Jarak dan Cluster Iterasi 2
| Data | Jarak C1 | Jarak C2 | Jarak C3 | Cluster |
|---|---|---|---|---|
| D1 - Pelanggan 1 | 1.0541 | 4.7376 | 6.5192 | C1 |
| D2 - Pelanggan 2 | 0.6667 | 3.3333 | 5.5227 | C1 |
| D3 - Pelanggan 3 | 1.0541 | 3.8006 | 6.6708 | C1 |
| D4 - Pelanggan 4 | 3.3333 | 0.6667 | 4.3012 | C2 |
| D5 - Pelanggan 5 | 4.7376 | 1.0541 | 4.3012 | C2 |
| D6 - Pelanggan 6 | 3.8006 | 1.0541 | 2.9155 | C2 |
| D7 - Pelanggan 7 | 5.7542 | 3.8006 | 0.7071 | C3 |
| D8 - Pelanggan 8 | 6.9602 | 5.2068 | 1.5811 | C3 |
| D9 - Pelanggan 9 | 5.6667 | 3.0732 | 0.7071 | C3 |
| D10 - Pelanggan 10 | 6.7412 | 3.4801 | 1.5811 | C3 |
Centroid Baru Iterasi 2
| Cluster | Anggota | Centroid Pendapatan | Centroid Pengeluaran |
|---|---|---|---|
| C1 | D1, D2, D3 | 2.3333 | 4.0000 |
| C2 | D4, D5, D6 | 5.6667 | 6.0000 |
| C3 | D7, D8, D9, D10 | 8.5000 | 3.5000 |
Centroid tidak berubah sehingga iterasi dihentikan.
#04 Hasil Akhir Cluster
Proses K-Means berhenti setelah 2 iterasi.
| Kode | Nama | Pendapatan | Pengeluaran | Cluster |
|---|---|---|---|---|
| D1 | Pelanggan 1 | 2 | 3 | C1 |
| D2 | Pelanggan 2 | 3 | 4 | C1 |
| D3 | Pelanggan 3 | 2 | 5 | C1 |
| D4 | Pelanggan 4 | 5 | 6 | C2 |
| D5 | Pelanggan 5 | 6 | 7 | C2 |
| D6 | Pelanggan 6 | 6 | 5 | C2 |
| D7 | Pelanggan 7 | 8 | 3 | C3 |
| D8 | Pelanggan 8 | 9 | 2 | C3 |
| D9 | Pelanggan 9 | 8 | 4 | C3 |
| D10 | Pelanggan 10 | 9 | 5 | C3 |
Centroid Akhir
| Cluster | Pendapatan | Pengeluaran | Jumlah Anggota |
|---|---|---|---|
| C1 | 2.3333 | 4.0000 | 3 |
| C2 | 5.6667 | 6.0000 | 3 |
| C3 | 8.5000 | 3.5000 | 4 |
Interpretasi Cluster
- C1: Pelanggan 1, Pelanggan 2, Pelanggan 3. Centroid akhir (2.3333, 4.0000).
- C2: Pelanggan 4, Pelanggan 5, Pelanggan 6. Centroid akhir (5.6667, 6.0000).
- C3: Pelanggan 7, Pelanggan 8, Pelanggan 9, Pelanggan 10. Centroid akhir (8.5000, 3.5000).
K-Means menghasilkan nomor cluster, bukan label bisnis secara otomatis. Label seperti rendah, menengah, atau tinggi sebaiknya diberikan setelah melihat karakteristik centroid dan konteks data.
K-Means vs Metode Clustering Lain
- K-Medoids menggunakan objek data aktual sebagai pusat cluster atau medoid.
- DBSCAN membentuk cluster berdasarkan kepadatan dan dapat menandai noise.
- Fuzzy C-Means memberikan derajat keanggotaan setiap data terhadap beberapa cluster.
Ringkasan
K-Means bekerja dengan menghitung jarak ke centroid, menentukan cluster terdekat, lalu menghitung centroid baru. Tahapan diulang sampai centroid stabil.
Pada contoh ini, 10 pelanggan dikelompokkan menjadi 3 cluster dan proses berhenti setelah 2 iterasi.
FAQ K-Means
Apa fungsi K-Means?
K-Means digunakan untuk mengelompokkan data yang memiliki karakteristik mirip tanpa label kelas sebelumnya.
Apa itu centroid?
Centroid adalah titik pusat cluster yang dihitung dari rata-rata nilai seluruh anggota cluster.
Bagaimana menentukan jumlah cluster K?
Nilai K dapat ditentukan berdasarkan kebutuhan analisis atau pengetahuan domain. Artikel sumber juga menyebut Elbow Method sebagai salah satu pendekatan evaluasi.
Mengapa hasil K-Means dapat berbeda?
Hasil dapat berbeda ketika centroid awal berbeda.
Kapan iterasi berhenti?
Iterasi berhenti ketika centroid tidak lagi berubah secara berarti atau batas maksimum iterasi tercapai.
Referensi
- MacQueen, J. (1967). Some Methods for Classification and Analysis of Multivariate Observations. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability.
- Han, J., Kamber, M., & Pei, J. (2012). Data Mining: Concepts and Techniques. Morgan Kaufmann.
Source Code K-Means


Ada yang Ditanyakan?
Jika masih ada kesulitan atau kekeliruan tentang metode di atas, silakan hubungi kami melalui halaman Kontak.
Perhitungan Excel tersedia melalui halaman Download, sedangkan aplikasi terkait dapat dilihat pada halaman Daftar Source Code.
Donasi digunakan untuk biaya server dan mendukung pembuatan tutorial metode atau algoritma lainnya.




Komentar
Tulis Komentar