K-Medoids: Contoh Perhitungan Clustering Manual
Diterbitkan 25 September 2026
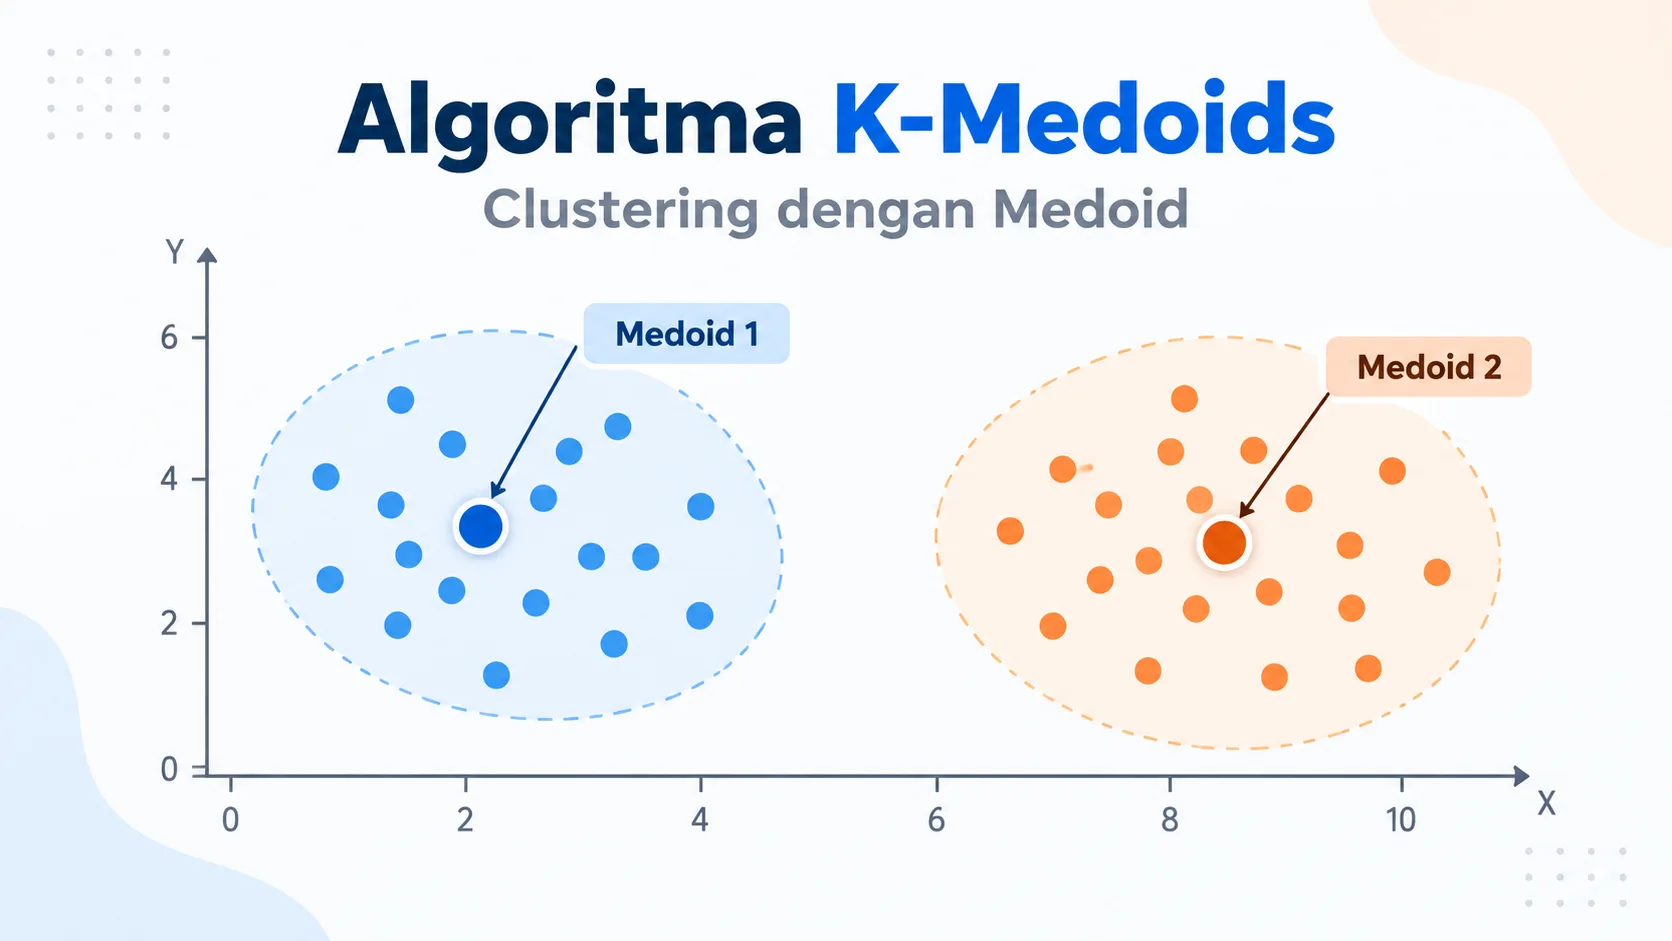
K-Medoids adalah algoritma clustering yang mirip dengan K-Means, tetapi pusat cluster dipilih dari objek data asli yang disebut medoid. Karena pusat cluster berasal dari data asli, K-Medoids cenderung lebih tahan terhadap outlier dibanding K-Means.
Tutorial ini membahas algoritma PAM (Partitioning Around Medoids) menggunakan 6 data pelanggan dan 2 cluster. Perhitungan dilakukan lengkap mulai dari pemilihan medoid awal, menghitung jarak Euclidean, menentukan cluster terdekat, menghitung total cost, melakukan swap medoid, sampai mendapatkan hasil cluster akhir.
Untuk perbandingan metode clustering lain, lihat juga algoritma K-Means, metode DBSCAN, dan Fuzzy C-Means.
Daftar Isi
- Pengertian K-Medoids
- Perbedaan K-Medoids dan K-Means
- Istilah Penting
- Rumus Jarak Euclidean
- Tahapan Algoritma PAM
- Contoh Kasus K-Medoids
- Hasil Clustering
- Interpretasi Hasil
- Pseudocode K-Medoids
- Kelebihan dan Kekurangan
- Kapan K-Medoids Cocok Digunakan?
- Ringkasan
- FAQ K-Medoids
- Referensi
- Source Code K-Medoids
Pengertian K-Medoids
K-Medoids adalah metode clustering partisional yang membagi data menjadi beberapa kelompok berdasarkan kemiripan. Setiap cluster diwakili oleh satu objek nyata dari dataset yang disebut:
Medoid
Tujuan K-Medoids adalah meminimalkan total jarak semua objek terhadap medoid cluster masing-masing.
Perbedaan K-Medoids dan K-Means
| Aspek | K-Medoids | K-Means |
|---|---|---|
| Pusat cluster | Objek data asli | Rata-rata (centroid) |
| Sensitif outlier | Lebih tahan | Lebih sensitif |
| Proses update | Swap medoid | Hitung centroid baru |
| Interpretasi pusat cluster | Lebih nyata | Nilai rata-rata |
| Cocok untuk | Data dengan outlier | Data numerik bersih |
Jika ingin memahami pendekatan centroid, pelajari juga K-Means.
Istilah Penting
| Istilah | Keterangan |
|---|---|
| Cluster | Kelompok data yang mirip |
| Medoid | Objek nyata yang menjadi pusat cluster |
| Cost | Total jarak seluruh data ke medoid terdekat |
| Swap | Pertukaran medoid dengan non-medoid |
| PAM | Partitioning Around Medoids |
| Outlier | Data ekstrem yang berbeda dari sebagian besar data |
Rumus Jarak Euclidean
Untuk dua titik:
dan:
jarak Euclidean:
Rumus ini digunakan untuk menghitung jarak setiap objek ke setiap medoid.
Tahapan Algoritma PAM
Alur umum K-Medoids:
Tentukan jumlah cluster k
↓
Pilih medoid awal
↓
Hitung jarak setiap data ke medoid
↓
Tempatkan data ke medoid terdekat
↓
Hitung total cost
↓
Coba swap medoid dengan non-medoid
↓
Pilih cost terkecil
↓
Ulangi sampai tidak ada perbaikan
Contoh Kasus K-Medoids
Kasus yang digunakan adalah segmentasi 6 pelanggan dengan 2 atribut:
- X1 = skor frekuensi belanja
- X2 = skor nilai transaksi
Jumlah cluster:
#01 Menentukan Data
| Kode | Nama | X1 | X2 |
|---|---|---|---|
| A1 | Pelanggan A | 2 | 2 |
| A2 | Pelanggan B | 2 | 3 |
| A3 | Pelanggan C | 3 | 2 |
| A4 | Pelanggan D | 8 | 8 |
| A5 | Pelanggan E | 8 | 9 |
| A6 | Pelanggan F | 9 | 8 |
Dari tabel di atas terlihat ada dua kelompok alami:
- kelompok dekat titik kecil \((2,2)\),
- kelompok dekat titik besar \((8,8)\).
#02 Menentukan Medoid Awal
Misalkan medoid awal dipilih:
M1 = A1
M2 = A2
Artinya pusat cluster awal adalah:
- A1 = (2,2)
- A2 = (2,3)
#03 Menghitung Matriks Jarak
Contoh perhitungan:
Jarak A3 ke A1
Jarak A4 ke A2
Matriks jarak utama:
| Data | ke A1 | ke A2 |
|---|---|---|
| A1 | 0.0000 | 1.0000 |
| A2 | 1.0000 | 0.0000 |
| A3 | 1.0000 | 1.4142 |
| A4 | 8.4853 | 7.8102 |
| A5 | 9.2195 | 8.4853 |
| A6 | 9.2195 | 8.6023 |
#04 Menentukan Cluster Awal
Setiap data ditempatkan ke medoid dengan jarak terkecil.
| Data | Jarak ke A1 | Jarak ke A2 | Medoid Terdekat | Cluster |
|---|---|---|---|---|
| A1 | 0.0000 | 1.0000 | A1 | C1 |
| A2 | 1.0000 | 0.0000 | A2 | C2 |
| A3 | 1.0000 | 1.4142 | A1 | C1 |
| A4 | 8.4853 | 7.8102 | A2 | C2 |
| A5 | 9.2195 | 8.4853 | A2 | C2 |
| A6 | 9.2195 | 8.6023 | A2 | C2 |
Hasil cluster awal:
C1 = {A1, A3}
C2 = {A2, A4, A5, A6}
#05 Menghitung Total Cost
Total cost adalah jumlah jarak minimum setiap objek ke medoid terdekat.
Semakin kecil cost, semakin baik konfigurasi medoid.
#06 Mencoba Swap Medoid
Sekarang dicoba pertukaran medoid dengan objek non-medoid:
- ganti A1 dengan A3, A4, A5, atau A6,
- ganti A2 dengan A3, A4, A5, atau A6.
Beberapa kandidat swap:
| Swap | Medoid Baru | Total Cost |
|---|---|---|
| A1 → A3 | {A2, A3} | 24.4836 |
| A2 → A4 | {A1, A4} | 3.4142 |
| A2 → A5 | {A1, A5} | 4.0000 |
| A2 → A6 | {A1, A6} | 4.0000 |
Terlihat swap terbaik sementara adalah:
A2 diganti A4
dengan cost:
#07 Memilih Swap Terbaik
Karena:
maka konfigurasi medoid diperbarui menjadi:
M1 = A1
M2 = A4
Sekarang hitung ulang cluster.
| Data | ke A1 | ke A4 | Medoid Terdekat | Cluster |
|---|---|---|---|---|
| A1 | 0.0000 | 8.4853 | A1 | C1 |
| A2 | 1.0000 | 7.8102 | A1 | C1 |
| A3 | 1.0000 | 7.8102 | A1 | C1 |
| A4 | 8.4853 | 0.0000 | A4 | C2 |
| A5 | 9.2195 | 1.0000 | A4 | C2 |
| A6 | 9.2195 | 1.0000 | A4 | C2 |
Cluster baru:
C1 = {A1, A2, A3}
C2 = {A4, A5, A6}
Cost baru:
Dalam contoh pembulatan rinci PAM, hasil sangat dekat dengan 4 dan jauh lebih baik dari cost awal.
#08 Iterasi Akhir
Selanjutnya dilakukan swap lagi dari medoid:
{A1, A4}
Ketika dicoba mengganti A1 atau A4 dengan non-medoid lain, tidak diperoleh cost yang lebih kecil daripada konfigurasi ini.
Maka algoritma berhenti.
Medoid akhir:
A1 dan A4
Hasil Clustering
Hasil akhir K-Medoids:
| Cluster | Medoid | Anggota |
|---|---|---|
| C1 | A1 | A1, A2, A3 |
| C2 | A4 | A4, A5, A6 |
Visual interpretasi:
Cluster 1 → pelanggan dengan skor belanja lebih rendah
Cluster 2 → pelanggan dengan skor belanja lebih tinggi
Interpretasi Hasil
Cluster pertama berisi pelanggan dengan frekuensi dan nilai transaksi yang relatif kecil.
Cluster kedua berisi pelanggan dengan frekuensi dan nilai transaksi yang tinggi.
Dengan demikian, hasil clustering dapat digunakan untuk:
- segmentasi pelanggan,
- penentuan promosi,
- klasifikasi pelanggan aktif,
- analisis perilaku belanja.
Jika data mengandung noise atau bentuk cluster tidak beraturan, Anda juga dapat membandingkan hasilnya dengan DBSCAN.
Pseudocode K-Medoids
input:
    dataset
    jumlah cluster k

pilih k medoid awal

repeat:
    hitung jarak setiap data ke setiap medoid
    tetapkan data ke medoid terdekat
    hitung total cost

    coba setiap swap medoid
    dengan non-medoid

    pilih swap dengan cost terkecil

until tidak ada cost yang lebih kecil

output:
    medoid akhir
    anggota tiap cluster
Kelebihan dan Kekurangan
Kelebihan K-Medoids
- Lebih tahan terhadap outlier dibanding K-Means.
- Pusat cluster berupa objek nyata dari dataset.
- Hasil cluster mudah diinterpretasikan.
- Cocok untuk analisis segmentasi yang membutuhkan representasi nyata.
Kekurangan K-Medoids
- Komputasi lebih berat dibanding K-Means pada data besar.
- Proses swap dapat memerlukan banyak percobaan.
- Hasil tetap dipengaruhi pemilihan medoid awal.
- Perlu menentukan jumlah cluster \(k\) di awal.
Kapan K-Medoids Cocok Digunakan?
K-Medoids cocok digunakan ketika:
- data mengandung outlier,
- dibutuhkan pusat cluster berupa data nyata,
- jumlah data tidak terlalu besar,
- analisis segmentasi membutuhkan interpretasi kuat,
- dan ingin alternatif yang lebih robust daripada K-Means.
Ringkasan
Pada contoh ini digunakan:
6 data pelanggan
2 atribut
2 cluster
Medoid awal:
A1 dan A2
Cost awal:
Setelah swap terbaik:
A1 dan A4
Cost turun menjadi sekitar:
Hasil akhir:
C1 = {A1, A2, A3}
C2 = {A4, A5, A6}
K-Medoids menghasilkan cluster yang jelas dan pusat cluster berupa data nyata. Untuk pembanding, pelajari juga K-Means dan DBSCAN.
FAQ K-Medoids
Apa itu K-Medoids?
K-Medoids adalah algoritma clustering yang menggunakan objek data asli sebagai pusat cluster.
Apa beda K-Medoids dan K-Means?
K-Medoids memakai medoid dari data nyata, sedangkan K-Means memakai centroid berupa nilai rata-rata.
Mengapa K-Medoids lebih tahan outlier?
Karena pusat cluster tidak dihitung dari rata-rata, tetapi dipilih dari data aktual.
Apa itu PAM?
PAM adalah singkatan dari Partitioning Around Medoids, yaitu algoritma klasik untuk K-Medoids.
Apakah K-Medoids harus menentukan jumlah cluster?
Ya, jumlah cluster \(k\) harus ditentukan di awal.
Apakah K-Medoids bisa untuk data non-numerik?
Bisa, selama tersedia ukuran jarak atau dissimilarity yang sesuai.
Kapan sebaiknya memilih K-Medoids?
Saat data mengandung outlier atau ketika pusat cluster harus berupa objek nyata.
Referensi
- Kaufman, L., & Rousseeuw, P. J. (1990). Finding Groups in Data: An Introduction to Cluster Analysis. Wiley.
- Han, J., Kamber, M., & Pei, J. (2012). Data Mining: Concepts and Techniques. Morgan Kaufmann.
- Tan, P. N., Steinbach, M., & Kumar, V. (2019). Introduction to Data Mining. Pearson.
Source Code K-Medoids
Berikut source code yang menggunakan metode K-Medoids pada RumahSourceCode.
Ada yang Ditanyakan?
Jika masih ada kesulitan atau kekeliruan tentang metode di atas, silakan hubungi kami melalui halaman Kontak.
Perhitungan Excel tersedia melalui halaman Download, sedangkan aplikasi terkait dapat dilihat pada halaman Daftar Source Code.
Donasi digunakan untuk biaya server dan mendukung pembuatan tutorial metode atau algoritma lainnya.




Komentar
Tulis Komentar