K-Nearest Neighbor (KNN): Contoh Perhitungan Manual
Diterbitkan 24 September 2026
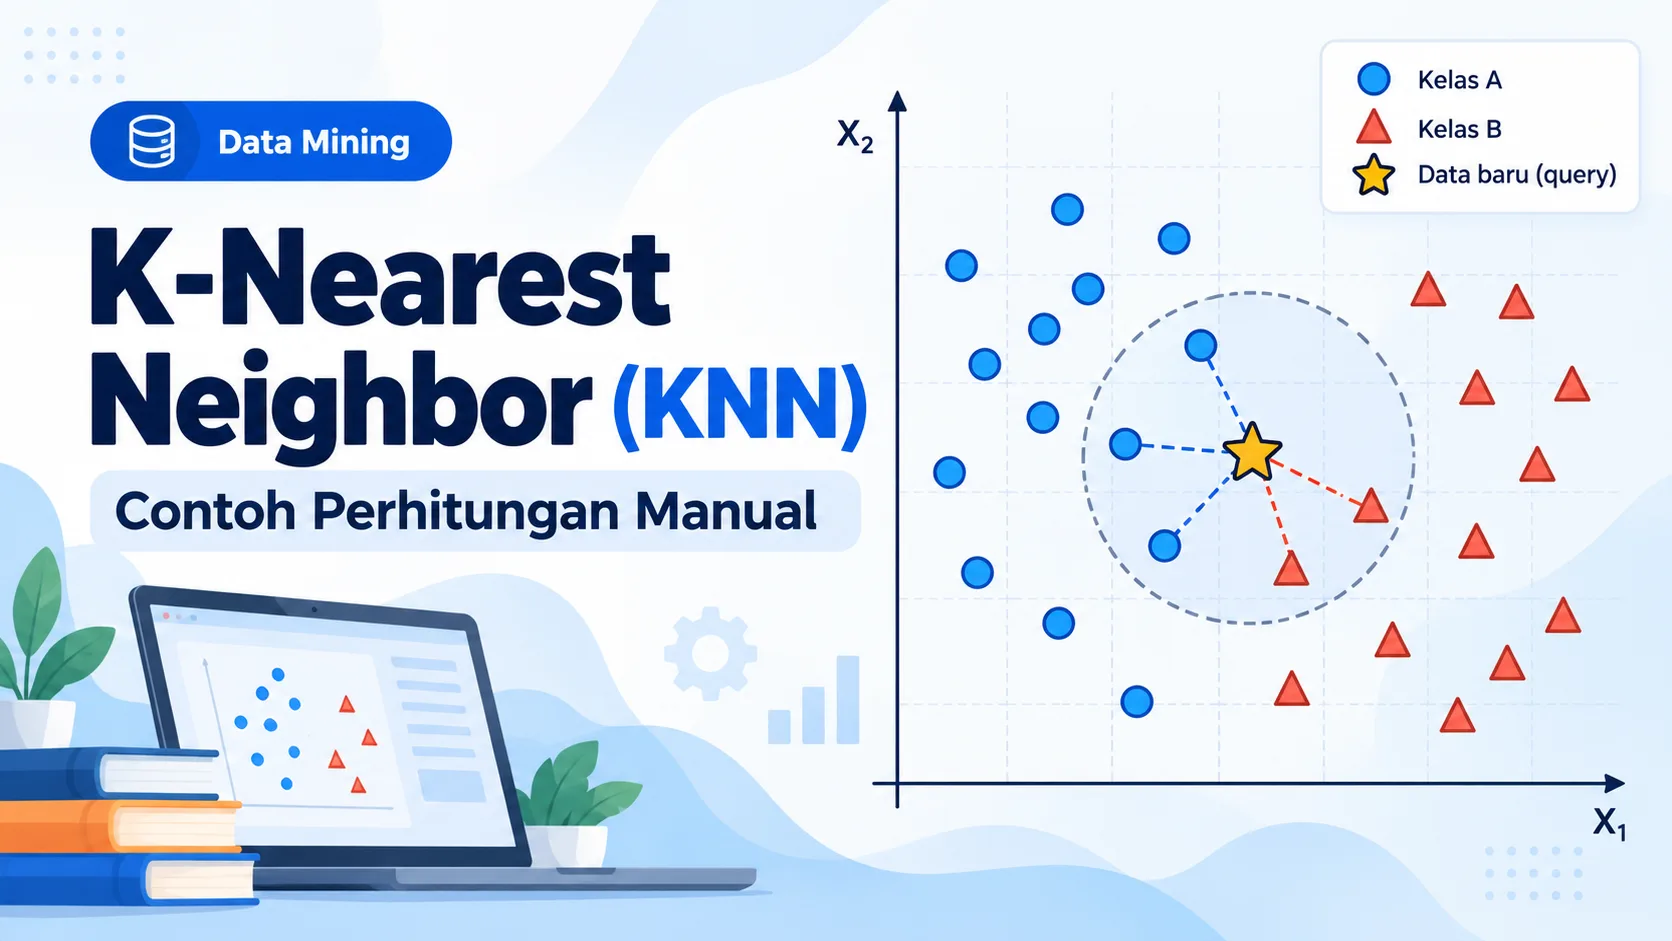
K-Nearest Neighbor (KNN) adalah algoritma supervised learning yang dapat digunakan untuk klasifikasi maupun regresi. Pada klasifikasi, KNN menentukan kelas data baru berdasarkan kelas dari sejumlah K tetangga terdekat.
Tutorial ini menggunakan contoh klasifikasi sederhana dengan dua atribut numerik. Perhitungan dilakukan mulai dari menentukan nilai K, menghitung Euclidean Distance, mengurutkan jarak, memilih tetangga terdekat, hingga menentukan kelas menggunakan majority voting.
Untuk membandingkan metode klasifikasi lain, lihat juga algoritma ID3, Decision Tree C4.5, dan metode Bayes. Jika ingin melihat metode lain yang juga menggunakan konsep kemiripan atau kedekatan kasus, lihat Case Based Reasoning.
Daftar Isi
- Pengertian KNN
- Cara Kerja KNN
- Rumus Euclidean Distance
- #01 Menyiapkan Data Latih
- #02 Menentukan Data Uji
- #03 Menentukan Nilai K
- #04 Menghitung Jarak
- #05 Mengurutkan Tetangga Terdekat
- #06 Majority Voting
- #07 Hasil Klasifikasi
- Kelebihan dan Kekurangan
- KNN vs CBR
- Ringkasan
- FAQ KNN
- Referensi
- Source Code KNN
Pengertian KNN
K-Nearest Neighbor adalah algoritma yang menentukan hasil prediksi berdasarkan data latih yang paling dekat dengan data baru.
Pada klasifikasi:
Data uji
↓
Hitung jarak ke seluruh data latih
↓
Urutkan dari jarak terkecil
↓
Ambil K tetangga terdekat
↓
Hitung jumlah kelas
↓
Pilih kelas mayoritas
KNN tidak membangun model pohon atau rule pada tahap pelatihan. Data latih digunakan langsung ketika proses prediksi dilakukan.
Cara Kerja KNN
Tahapan dasar KNN untuk klasifikasi:
- Menyiapkan data latih yang sudah memiliki label kelas.
- Menentukan nilai K.
- Menghitung jarak data uji terhadap seluruh data latih.
- Mengurutkan jarak dari yang terkecil.
- Mengambil K data terdekat.
- Melakukan majority voting.
- Menentukan kelas data uji.
Rumus Euclidean Distance
Untuk dua data:
dan:
Euclidean Distance:
Untuk dua atribut:
Nilai jarak yang lebih kecil menunjukkan data yang lebih dekat.
#01 Menyiapkan Data Latih
Contoh berikut merupakan data ilustratif untuk menjelaskan perhitungan manual KNN.
| Kode | X1 | X2 | Kelas |
|---|---|---|---|
| D1 | 2 | 3 | Reguler |
| D2 | 3 | 4 | Reguler |
| D3 | 3 | 2 | Reguler |
| D4 | 4 | 4 | Prioritas |
| D5 | 5 | 4 | Prioritas |
| D6 | 6 | 5 | Prioritas |
| D7 | 7 | 6 | Prioritas |
| D8 | 8 | 7 | Prioritas |
Pada contoh ini terdapat dua kelas:
Reguler
Prioritas
#02 Menentukan Data Uji
Data baru yang akan diklasifikasikan:
X1 = 5
X2 = 5
Sehingga:
Kelas data uji belum diketahui.
#03 Menentukan Nilai K
Pada contoh digunakan:
Artinya hasil klasifikasi ditentukan dari 3 tetangga terdekat.
Nilai K pada sistem nyata perlu dipilih dan dievaluasi sesuai karakteristik data. Nilai K pada tutorial ini hanya digunakan untuk memudahkan perhitungan manual.
#04 Menghitung Jarak
Contoh Jarak Data D1
D1:
Data uji:
Maka:
Contoh Jarak Data D5
D5:
Maka:
Hasil seluruh jarak:
| Kode | X1 | X2 | Kelas | Jarak |
|---|---|---|---|---|
| D1 | 2 | 3 | Reguler | 3.6056 |
| D2 | 3 | 4 | Reguler | 2.2361 |
| D3 | 3 | 2 | Reguler | 3.6056 |
| D4 | 4 | 4 | Prioritas | 1.4142 |
| D5 | 5 | 4 | Prioritas | 1.0000 |
| D6 | 6 | 5 | Prioritas | 1.0000 |
| D7 | 7 | 6 | Prioritas | 2.2361 |
| D8 | 8 | 7 | Prioritas | 3.6056 |
#05 Mengurutkan Tetangga Terdekat
Jarak kemudian diurutkan dari nilai terkecil.
| Rank Jarak | Kode | Kelas | Jarak |
|---|---|---|---|
| 1 | D5 | Prioritas | 1.0000 |
| 2 | D6 | Prioritas | 1.0000 |
| 3 | D4 | Prioritas | 1.4142 |
| 4 | D2 | Reguler | 2.2361 |
| 5 | D7 | Prioritas | 2.2361 |
| 6 | D1 | Reguler | 3.6056 |
| 7 | D3 | Reguler | 3.6056 |
| 8 | D8 | Prioritas | 3.6056 |
Karena:
maka tiga tetangga yang digunakan adalah:
| Tetangga | Kode | Kelas | Jarak |
|---|---|---|---|
| 1 | D5 | Prioritas | 1.0000 |
| 2 | D6 | Prioritas | 1.0000 |
| 3 | D4 | Prioritas | 1.4142 |
#06 Majority Voting
Tiga tetangga terdekat adalah:
D5 → Prioritas
D6 → Prioritas
D4 → Prioritas
Jumlah kelas:
Prioritas = 3
Reguler   = 0
Kelas mayoritas adalah:
#07 Hasil Klasifikasi
Data uji:
dengan:
diklasifikasikan sebagai:
Hasil tersebut berlaku untuk data ilustratif, nilai K, dan distance metric yang digunakan pada contoh ini.
Kelebihan dan Kekurangan
Kelebihan KNN
- Konsep mudah dipahami.
- Tidak membutuhkan proses pembentukan model yang kompleks.
- Dapat digunakan untuk klasifikasi maupun regresi.
- Dapat menggunakan berbagai ukuran jarak sesuai kebutuhan data.
Kekurangan KNN
- Prediksi dapat menjadi lebih berat ketika data latih sangat besar.
- Hasil sensitif terhadap nilai K.
- Skala atribut dapat memengaruhi perhitungan jarak.
- Hasil dapat dipengaruhi data yang tidak relevan atau noise.
KNN vs CBR
KNN dan Case Based Reasoning sama-sama dapat menggunakan konsep kedekatan, tetapi tujuan dan prosesnya berbeda.
| Aspek | KNN | CBR |
|---|---|---|
| Fokus | Klasifikasi atau regresi | Pemecahan masalah berbasis kasus |
| Data utama | Data latih berlabel | Kasus lama beserta solusi |
| Proses | K tetangga dan voting/agregasi | Retrieve, Reuse, Revise, Retain |
| Hasil | Kelas atau nilai | Solusi dari kasus yang relevan |
Untuk klasifikasi berbasis pohon keputusan, bandingkan juga dengan ID3 dan C4.5.
Ringkasan
Pada contoh ini:
Jumlah data latih = 8
K = 3
Data uji = (5,5)
Tiga tetangga terdekat:
D5 = 1.0000 → Prioritas
D6 = 1.0000 → Prioritas
D4 = 1.4142 → Prioritas
Hasil majority voting:
Prioritas = 3
Reguler   = 0
Sehingga data uji diklasifikasikan sebagai:
Prioritas
FAQ KNN
Apa kepanjangan KNN?
KNN adalah singkatan dari K-Nearest Neighbor.
Apa fungsi nilai K?
K menentukan jumlah tetangga terdekat yang digunakan untuk menghasilkan prediksi.
Apakah KNN hanya untuk klasifikasi?
Tidak. KNN juga dapat digunakan untuk regresi dengan mekanisme agregasi nilai tetangga.
Mengapa normalisasi data penting?
Jika atribut memiliki skala yang sangat berbeda, atribut dengan rentang besar dapat lebih dominan pada perhitungan jarak.
Apa perbedaan KNN dan Decision Tree?
KNN menentukan prediksi berdasarkan kedekatan data, sedangkan Decision Tree membentuk struktur keputusan berdasarkan pemisahan atribut.
Apa yang terjadi jika voting seri?
Implementasi perlu menentukan aturan tie-breaking, misalnya mempertimbangkan jarak yang lebih dekat atau menggunakan nilai K yang berbeda.
Referensi
- Cover, T. M., & Hart, P. E. (1967). Nearest Neighbor Pattern Classification. IEEE Transactions on Information Theory, 13(1), 21–27.
- Han, J., Kamber, M., & Pei, J. (2012). Data Mining: Concepts and Techniques. Morgan Kaufmann.
Source Code KNN


Ada yang Ditanyakan?
Jika masih ada kesulitan atau kekeliruan tentang metode di atas, silakan hubungi kami melalui halaman Kontak.
Perhitungan Excel tersedia melalui halaman Download, sedangkan aplikasi terkait dapat dilihat pada halaman Daftar Source Code.
Donasi digunakan untuk biaya server dan mendukung pembuatan tutorial metode atau algoritma lainnya.




Komentar
Tulis Komentar